In detail
Toegang bieden tot een kennisbank via AI
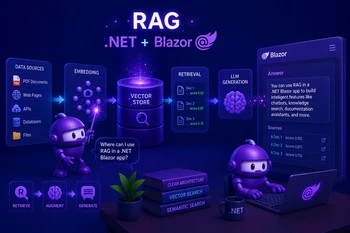
De beheersoftware waarover het hier gaat, beschikte al over een zeer uitgebreide kennisbank in de vorm van een webportaal. Het zoeken in deze documentatie werd soms bemoeilijkt doordat de « juiste woorden » moesten worden gebruikt om de meest relevante pagina’s te vinden. Hier komt AI in beeld en opent ze heel wat nieuwe mogelijkheden. Het systeem dat ik heb opgezet, is gebaseerd op een RAG-architectuur (Retrieval-Augmented Generation).
Concreet heb ik twee applicaties ontwikkeld:
- Een programma voor het voorbereiden van de informatie (vectorisatie), geschreven als een .NET-consoleapplicatie, dat dagelijks op een Linux-server wordt uitgevoerd.
- Een webportaal, ontwikkeld met Blazor, waarmee gebruikers op een conversationele manier met AI kunnen communiceren.
Informatiebronnen
De kennisbank van de software is uiteraard de eerste informatiebron. Maar er werden ook andere soorten inhoud toegevoegd om de documentatie die door het model wordt gebruikt verder te verrijken: oude legacy-handleidingen, bepaalde pagina’s van de commerciële website, de uitleg bij de algemene opties van het programma die in de interface beschikbaar is en ten slotte het schema van de SQL-database (in DDL-formaat).
Voorbereiding van de inhoud
Om door AI te kunnen worden gebruikt, moet al deze inhoud worden opgedeeld (chunking). De kennisbank bevat echter ook fragmenten C#-, SQL- of XAML-code. Deze moeten vooraf worden geëxtraheerd, omdat het opdelen van dergelijke code contraproductief zou zijn. De inhoud wordt genormaliseerd en alle HTML-tags moeten worden verwijderd. Het resultaat van deze opdeling wordt via .NET-code opgeslagen in een vectoriële Qdrant-database. De Qdrant-server draait op een Ubuntu-server.
Conversationeel portaal
Dit portaal is ontwikkeld met Blazor. De gebruiker formuleert er zijn vraag, aanvaardt de gebruiksvoorwaarden en valideert een captcha. Blazor is ideaal om het antwoord van de AI progressief weer te geven. Dat laatste is noodzakelijk omdat het denkproces anders lang zou kunnen lijken.
Paradoxaal genoeg is het moeilijkste onderdeel om op punt te stellen de systeemprompt, d.w.z. de instructies die de AI vertellen hoe ze moet antwoorden, wat ze niet mag zeggen, hoe ze de teruggestuurde inhoud moet structureren zodat achteraf opnieuw URL’s naar de kennisbank kunnen worden gekoppeld, …
In de praktijk zijn ook een hele reeks optimalisaties noodzakelijk:
- Detecteren of de vraag naar een heel specifieke pagina verwijst.
- Bevat de vraag namen van variabelen, parameters, … die moeilijk door de semantische zoekfunctie kunnen worden herkend? In dat geval moet een traditionele zoekopdracht (like %) worden toegevoegd.
De code normaliseert de vraag en vectoriseert ze op dezelfde manier als tijdens het proces voor de voorbereiding van de inhoud. Vervolgens wordt de zoekopdracht uitgevoerd, eerst in de tekstuele inhoud en daarna in de codefragmenten die gekoppeld zijn aan de pagina’s die tijdens de vorige stap werden gevonden. Er wordt een extra gewicht toegekend wanneer het eerste resultaat overeenkomt met een chunk die een paginatitel is.
Al deze resultaten vormen de potentieel relevante documentatie die naar de AI (ChatGPT) wordt gestuurd. Het antwoord wordt progressief aan de gebruiker weergegeven. Zodra het volledig is gegenereerd, kan de gebruiker het gesprek voortzetten en begint hetzelfde proces aan een nieuwe iteratie.
Dit portaal kan SQL-query’s samenstellen op basis van instructies in natuurlijke taal. Daarom beschikt het over het schema van de database. De praktijk heeft ook aangetoond dat het C#-code kan produceren, onder meer op basis van de voorbeelden die in de kennisbank zijn opgenomen.
Een RAG-architectuur transformeert bestaande documentatie zo in een echte conversationele kennisbank. AI vervangt de informatie die door de jaren heen werd opgebouwd niet: ze geeft er een nieuwe dimensie aan door het mogelijk te maken die informatie in natuurlijke taal te bevragen, bronnen van zeer uiteenlopende aard met elkaar te combineren en die kennis zelfs te gebruiken om SQL of code te produceren. De kwaliteit van het resultaat hangt daarbij evenzeer af van het gebruikte model als van de zorg die wordt besteed aan de voorbereiding, het zoeken en de selectie van de informatie die aan het model wordt verstrekt.